
Schriftliche DevOps-Schulung
Wie richten Sie Monitoring und Telemetrie für den DevOps-Softwarelebenszyklus ein?
Aus Ihrer IT-Erfahrung wissen Sie, wie schwer es sein kann, bei Störungen die Ursache zu ermitteln. Das Problem kann in den Anwendungen, den Umgebungen oder den Komponenten liegen, mit denen sie verbunden sind.
Ein häufiges Muster in den letzten 50 Jahren der Entwicklung komplexerer Client- und Serverplattformen: Sobald ein Server schlecht läuft, Fehler meldet und seinen Dienst nicht erfüllt, starten Sie ihn neu und hoffen auf Besserung. Ein Neustart kann ein unverstandenes Problem vorübergehend beseitigen. Hilft er nicht, landen Sie bei Entwicklern und Testern, die angeblich schlecht geliefert und Probleme beim Testen übersehen haben. Dieses Chaos beeinträchtigt die Kundenzufriedenheit und belastet das Arbeitsklima.
Führende DevOps-Organisationen starten Server bei der Fehlerbehebung kaum neu. Sie ermitteln und beheben Probleme systematisch. Produktionstelemetrie hilft ihnen, Ursachen und Einflussfaktoren zu verstehen. Ihre mittlere Wiederherstellungszeit (MTTR) ist 96-mal besser als bei anderen Organisationen. Das heißt, sie lösen Produktionsprobleme 96-mal schneller als ein durchschnittliches Unternehmen. Eine ihrer wichtigsten technischen Praktiken ist die Einbindung von Telemetrie in Software und Anwendungen.
Was ist Telemetrie?
Einfach gesagt zeichnet Telemetrie das Verhalten Ihrer Systeme auf.
Gestalten Sie Software, Produktions- und Vorproduktionsumgebungen sowie die Deployment-Pipeline so, dass sie kontinuierlich Telemetriedaten erzeugen. Erfassen Sie genügend Daten, um zu bestätigen, dass Ihre Dienste in Produktion ordnungsgemäß funktionieren. Tritt ein Problem auf, erkennen Sie anhand der Daten schnell, worum es geht, und können eine fundierte Entscheidung zur Behebung treffen.
Telemetrie hilft Ihnen auch, Ihr Verständnis davon, was in Produktion geschieht, mit dem tatsächlichen Geschehen abzugleichen.
Bauen Sie Ihre Telemetrie-Infrastruktur auf
Für Telemetrie brauchen Sie zwei zentrale Komponenten:
- Erfassung von Telemetriemetriken: Alle leistungsstarken DevOps-Organisationen zeichnen laufend Hunderttausende Kennzahlen auf jeder Ebene ihrer Anwendungen, Umgebungen und Deployment-Pipelines auf. Beispiele sind Geschäftsereignisse wie Verkäufe und Zustandsprüfungen der Serverplattform, etwa die Überwachung von Betriebssystemen, Datenbanken, Datenträger- und Netzwerk-E/A, Arbeitsspeicher, CPU und Sicherheit.
- Eine zentrale Plattform zur Verwaltung von Telemetriemetriken: Die Plattform speichert Metriken und Ereignisse. Sie ermöglicht Visualisierung, Trendanalyse, Stichproben, Alarmierung und Anomalieerkennung. Sie wandelt Protokolle in Metriken um, etwa die Anzahl schwerwiegender Ausnahmen einer Anwendung. Ereignisse in der Deployment-Pipeline wie Commits, Rollbacks, Installationen, Deinstallationen und automatisierte Testergebnisse aus Produktion und Vorproduktion sollten ebenfalls in dieser Infrastruktur gespeichert werden.
Sie, Ihr Team und alle beteiligten Stakeholder sollten Telemetriedaten über Self-Service-APIs und grafische Oberflächen selbst abrufen können, ohne dafür Tickets eröffnen zu müssen.
Alle Telemetriedaten müssen für Ihre gesamte Organisation zu 100 % zugänglich sein. Ausgenommen sind Metriken, die den Datenschutz verletzen oder die Sicherheit Ihrer Kunden gefährden können.
Arten von Telemetriemetriken
- Metriken der Geschäftsebene: Etwa A/B-Testergebnisse, Gewinn, Umsatz, Anzahl neuer Nutzer, durchschnittliche Sitzungsdauer, abgeschlossene Bestellungen und abgebrochene Kaufvorgänge.
- Metriken der Anwendungsebene: Etwa Anwendungsantwortzeiten, Transaktionsdauer, Anzahl der Core Dumps und Anzahl schwerwiegender Ausnahmen.
- Metriken der Infrastrukturebene: Etwa Serververkehr, Datenträger- und Netzwerk-E/A, Arbeitsspeicher-, CPU- und Datenträgerauslastung.
- Metriken der Client-Ebene: Etwa Antwortzeiten und Fehler von Web-, Mobil-, JavaScript- und anderen Client-Anwendungen.
- Metriken der Deployment-Pipeline: Etwa Check-ins, Durchlaufzeiten und Häufigkeit von Deployments, Umgebungszustand und grüne, gelbe oder rote Statusanzeigen nach automatisierten Tests.
Ordnen Sie Ihre Metriken in Kategorien und Unterkategorien, damit Ihr DevOps-Team sie leicht auswerten kann.
Gestalten Sie die Protokolleinträge Ihrer Anwendungen verständlich, damit sie sich später in Telemetriemetriken umwandeln lassen. Wie bei Protokollen können Sie auch Metriken nach Ereigniskategorien gruppieren, etwa in die Stufen Debug, Info, Warn, Error und Fatal.
Nutzen Sie Telemetriedaten zur gezielten Problemlösung
In einer Kultur der Schuldzuweisung will niemand Produktionsänderungen vollständig offenlegen oder Telemetrie zeigen. In einem solchen Umfeld werden Ursachen selten korrekt erkannt. Vor allem lernt die Organisation nichts Neues.
Machen Sie die Erstellung von Telemetrie zur täglichen Aufgabe des gesamten Teams, damit sie die Problemlösung unterstützen kann. Entwickeln Sie leicht nutzbare Bibliotheken, sodass eine Zeile Code genügt, um einen Telemetrieeintrag zu erzeugen.
Erfassen Sie auch Schreibvorgänge in der Versionsverwaltung und den laufenden Umgebungen. So können Sie anhand der Telemetrie leicht darstellen, wie Systemänderungen und ihre Auswirkungen auf Kunden zusammenhängen.
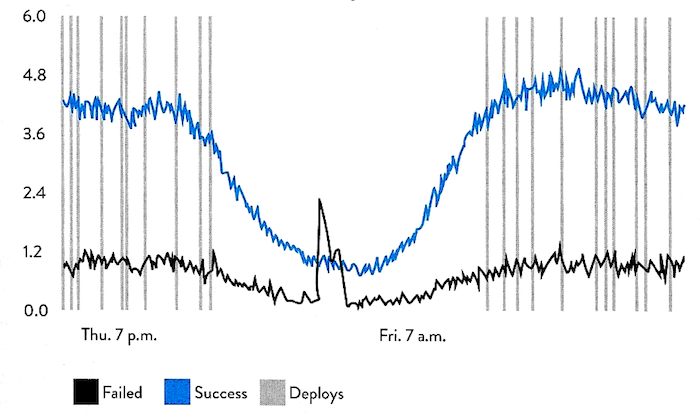
Ein Beispiel: Die folgende Grafik zeigt, dass eines der letzten Deployments am Donnerstagabend wahrscheinlich den Anstieg fehlgeschlagener Käufe im Checkout verursacht hat.
Erfolgreiche und fehlgeschlagene Deployments mit der Geschäftsaktivität im Zeitverlauf vergleichen.
 Originaldiagramm ansehen ↗
(Quelle: Measure Anything, Measure Everything, DevOps Handbook)
Mit Telemetrie können Sie genauer über Probleme sprechen. Sie und Ihre Teams haben voreinander und vor den Stakeholdern nichts zu verbergen. Beobachten Sie solche Diagramme laufend und zeigen Sie sie den Stakeholdern in Echtzeit. So erkennen Sie Probleme schnell und sehen mögliche Zusammenhänge zwischen Deployments und wichtigen Geschäftsereignissen. Die Fachbereiche erhalten Einblick in die Arbeit des Teams. DevOps-Entwickler und DevOps Operations Engineers erkennen außerdem Zusammenhänge zwischen Vorfällen und Deployments.
Telemetrie macht Probleme sichtbar, solange sie leicht und kostengünstig zu beheben sind. So korrigieren Sie sie, bevor sie sich ausbreiten und weitere Probleme verursachen.
Mit Telemetrie erkennen Sie und Ihr Team Muster in wichtigen Geschäfts- und Technologiemetriken und richten Alarme für Anomalien ein. Anfangs können Schwellenwerte falsch sein und Fehlalarme auslösen. Das ist normal. Bleiben Sie ruhig und lassen Sie sich nicht davon abbringen, Zeit und Ressourcen in die Telemetrie-Infrastruktur zu investieren. Wie bei anderen komplexen Systemen werden Sie auch hier geeignete Schwellenwerte finden und so anpassen, dass sie für Sie, Ihre Kunden und Ihr Geschäft funktionieren.
FAZIT
Führende DevOps-Organisationen machen die Auswirkungen von Problemen in Geschäftskennzahlen sichtbar, etwa durch die Zahl verlorener Kunden oder entgangenen Umsatz. So wächst in der gesamten Organisation das Bewusstsein für Telemetrie, sowohl in Produktion als auch in Vorproduktion. Sie investieren Zeit und Ressourcen in ihren Aufbau und ihre Nutzung und verlassen sich darauf, um Fehler schnell zu erkennen und zu beheben.
