
Formación escrita en DevOps
¿Cómo implementar la monitorización (telemetría) para gestionar el ciclo de vida del software con DevOps?
Por su experiencia en TI, ya sabrá que cuando algo sale mal no es fácil identificar la causa raíz. El problema puede estar en las aplicaciones, en los entornos o en otros componentes con los que se integran.
Al repasar la evolución de plataformas cliente-servidor relativamente complejas durante los últimos 50 años, se repite una situación: cuando un servidor funciona mal, devuelve errores y no presta el servicio esperado, basta con reiniciarlo y esperar que se resuelva el problema. A veces un reinicio elimina temporalmente un problema que nunca se llegó a entender. Si eso no funciona, el siguiente paso es acudir a desarrollo y pruebas, que supuestamente no entregaron bien el software o no detectaron los problemas al probarlo. Todo ese caos perjudica la satisfacción de los clientes y el ambiente de trabajo.
Las organizaciones DevOps de alto rendimiento apenas reinician sus servidores al resolver problemas. Emplean métodos sistemáticos para detectarlos y resolverlos. Recurren a la telemetría de producción para comprender las causas raíz y los factores que contribuyen a los problemas, en lugar de reiniciar a ciegas. Su tiempo medio de recuperación (MTTR) es 96 veces mejor que el de otras organizaciones. En otras palabras, resuelven los problemas en producción 96 veces más rápido que una empresa media. Una de sus principales prácticas técnicas es incorporar telemetría al software y las aplicaciones.
¿Qué es la telemetría?
En pocas palabras, la telemetría es el proceso de registrar el comportamiento de los sistemas.
Para ello, diseñe el software, los entornos de producción y preproducción y la canalización de despliegue de modo que generen registros de telemetría continuamente. El objetivo es contar con datos suficientes para confirmar que los servicios funcionan correctamente en producción. Cuando ocurre un problema, consultar esos registros le permite entenderlo pronto y tomar decisiones informadas para corregirlo.
La telemetría también permite contrastar lo que cree que sucede en producción con lo que realmente ocurre y ver si coincide.
Construya su infraestructura de telemetría
Para contar con telemetría, necesita dos componentes principales:
- Registro de métricas de telemetría: Todas las organizaciones DevOps de alto rendimiento registran continuamente cientos de miles de métricas en cada capa de sus aplicaciones, entornos y canalizaciones de despliegue. Algunos ejemplos son los eventos de la lógica de negocio, como el número de ventas, y las comprobaciones del estado de la plataforma de servidores, como la monitorización de sistemas operativos, bases de datos, operaciones de E/S de disco y red, RAM, CPU y seguridad.
- Una plataforma central para gestionar las métricas de telemetría: Esta plataforma almacena métricas y eventos. Permite visualizarlos, analizar tendencias, hacer muestreos, generar alertas y detectar anomalías. Convierte los registros en métricas, como el número de excepciones fatales de una aplicación. La misma infraestructura también debería almacenar los eventos de la canalización de despliegue, como commits, reversiones, instalaciones, desinstalaciones y resultados de pruebas automatizadas en producción y preproducción.
Usted, su equipo de DevOps y todas las partes interesadas que colaboran con él deben poder consultar los datos de la plataforma por su cuenta mediante API e interfaces gráficas, sin abrir solicitudes para acceder a la telemetría.
Toda la organización debe poder acceder al 100 % de los datos de telemetría, salvo a las métricas que puedan vulnerar la privacidad y poner en riesgo la seguridad de los clientes.
Tipos de métricas de telemetría
- Métricas de la capa de negocio: Por ejemplo, resultados de pruebas A/B, beneficios, ingresos, número de usuarios nuevos, duración media de las sesiones, número de pedidos completados y procesos de compra abandonados.
- Métricas de la capa de aplicación: Por ejemplo, tiempos de respuesta de las aplicaciones, duración de las transacciones, número de volcados de memoria y número de excepciones fatales.
- Métricas de la capa de infraestructura: Por ejemplo, tráfico de servidores, operaciones de E/S de disco y red, y uso de RAM, CPU y disco.
- Métricas de la capa de cliente: Por ejemplo, tiempos de respuesta de las aplicaciones cliente y errores en aplicaciones web, móviles, JavaScript y otros clientes.
- Métricas de la capa de canalización de despliegue: Por ejemplo, cambios registrados, tiempos y frecuencias de despliegue, estado de los entornos y resultados en verde, ámbar o rojo tras ejecutar pruebas automatizadas.
Es fundamental organizar las métricas en jerarquías de categorías y subcategorías para que su equipo y usted puedan interpretarlas con facilidad.
Procure que las entradas de registro que se convertirán en métricas sean fáciles de entender. Al igual que agrupa los registros por categorías de eventos, agrupe también las métricas de telemetría. Un ejemplo son los niveles Debug, Info, Warn, Error y Fatal.
Use la telemetría para orientar la resolución de problemas
Si en la organización se buscan culpables, nadie quiere que los cambios en producción sean plenamente visibles ni está dispuesto a mostrar la telemetría. En ese ambiente, rara vez se identifican bien las causas raíz y, peor aún, la organización no aprende nada nuevo.
Para que la telemetría pueda guiar la resolución de problemas, convierta su creación en trabajo diario de todo el equipo de DevOps. Cree bibliotecas fáciles de usar para generar un registro de telemetría con una sola línea de código.
Genere también registros de telemetría para las operaciones de escritura del control de versiones y de los entornos en funcionamiento. Así, la monitorización mostrará con claridad la relación entre los cambios en los sistemas y su impacto en los clientes.
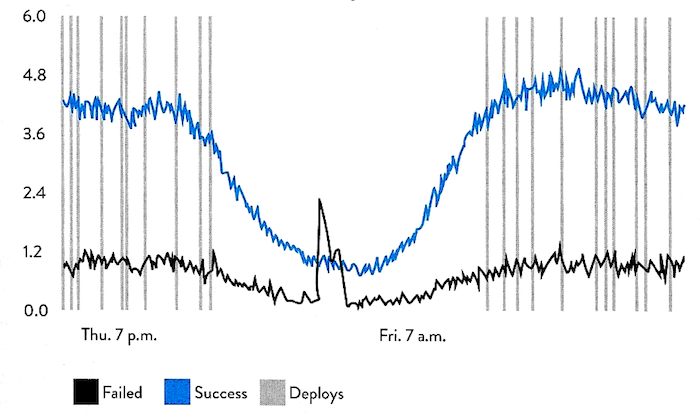
Por ejemplo, el gráfico siguiente muestra claramente que uno de los últimos despliegues del jueves por la tarde es una posible causa raíz del aumento de compras fallidas en el proceso de pago.
Compara los despliegues exitosos y fallidos con la actividad del negocio a lo largo del tiempo.
 Ver el diagrama original ↗
(Fuente: Measure Anything, Measure Everything, DevOps Handbook)
La telemetría le ayuda a comunicar los problemas en detalle. El equipo de DevOps y usted no tienen nada que ocultarse ni que ocultar a las partes interesadas. Por eso monitorizan continuamente los datos y presentan en tiempo real gráficos como el anterior para detectar problemas pronto y ver posibles relaciones de causa y efecto entre los despliegues y los eventos clave de negocio. El personal de negocio entiende mejor el trabajo del equipo y cuenta con más transparencia. Además, desarrollo y operaciones pueden ver la relación entre incidentes y despliegues.
La telemetría permite ver los problemas cuando todavía son fáciles y baratos de resolver, de modo que puede corregirlos antes de que se propaguen y se acumulen otros problemas encima.
Con telemetría, el equipo y usted pueden detectar patrones en las métricas clave de negocio y tecnología y generar alertas cuando aparezcan anomalías. Al principio, los umbrales pueden ser incorrectos y generar falsos positivos. Es normal. No se alarme ni deje que nadie desvalorice el esfuerzo y la inversión en la infraestructura de telemetría. Como en otros aspectos de sus sistemas complejos, irá aprendiendo y ajustará los umbrales de alerta para que sirvan a usted, sus clientes y su negocio.
CONCLUSIÓN
Las organizaciones DevOps de alto rendimiento expresan el impacto de los problemas en métricas de negocio medibles, como el número de clientes perdidos o los ingresos no percibidos. Así, todo el mundo presta más atención a la telemetría en producción y preproducción. Invierten tiempo y recursos en construirla y utilizarla, y confían en ella para detectar y corregir errores rápidamente.
