
Formation DevOps écrite
Comment mettre en place la supervision (télémétrie) pour gérer le cycle de vie de vos logiciels DevOps ?
Votre expérience dans l’informatique vous a déjà montré qu’il est difficile de trouver la cause profonde d’un problème. Elle peut se situer dans vos applications logicielles, dans vos environnements ou dans d’autres composants auxquels ils sont intégrés.
Dans l’évolution des plateformes client et serveur relativement complexes au cours des 50 dernières années, un scénario revient souvent. Lorsqu’un serveur se comporte mal, produit des erreurs et ne fournit plus le service attendu, on le redémarre en espérant que cela résoudra le problème. Un redémarrage peut effectivement masquer temporairement un problème que vous n’avez jamais compris. Si cela ne suffit pas, vous vous tournez vers les développeurs et les testeurs, accusés d’avoir mal livré le logiciel ou mal détecté les problèmes pendant les tests. Ce chaos nuit à la satisfaction de vos clients et au climat de travail dans votre organisation.
Les organisations DevOps les plus performantes redémarrent rarement leurs serveurs pour résoudre un problème. Elles appliquent des méthodes systématiques pour détecter et corriger les difficultés. Elles s’appuient sur la télémétrie de production pour comprendre les causes profondes et les facteurs contributifs. Leur temps moyen de rétablissement (MTTR) est 96 fois meilleur que celui des autres organisations. Elles résolvent donc les problèmes de production 96 fois plus vite qu’une entreprise moyenne. L’une de leurs principales pratiques techniques est d’intégrer la télémétrie à leurs logiciels et applications.
Qu’est-ce que la télémétrie ?
En termes simples, la télémétrie consiste à enregistrer le comportement de vos systèmes.
Pour cela, concevez vos logiciels, vos environnements de production et de préproduction et votre pipeline de déploiement de façon à produire des données de télémétrie en continu. Vous devez disposer de suffisamment de données pour vérifier que vos services fonctionnent correctement en production. Lorsqu’un problème survient, leur consultation vous aide à le comprendre rapidement et à prendre des décisions éclairées pour le résoudre.
La télémétrie permet également de vérifier que votre compréhension de ce qui se passe en production correspond à la réalité.
Construisez votre infrastructure de télémétrie
La télémétrie repose sur deux composantes principales :
- Enregistrement des indicateurs de télémétrie : Les organisations DevOps les plus performantes enregistrent en permanence des centaines de milliers d’indicateurs à tous les niveaux de leurs applications, environnements et pipelines. Il peut s’agir d’événements métier comme le nombre de ventes ou d’indicateurs sur l’état des plateformes serveur, par exemple la supervision des systèmes d’exploitation, des bases de données, des entrées-sorties disque et réseau, de la mémoire vive, du processeur et de la sécurité.
- Une plateforme centrale de gestion des indicateurs de télémétrie : Cette plateforme stocke les indicateurs et les événements. Elle permet de visualiser les données, de suivre les tendances, d’échantillonner, de générer des alertes et de détecter des anomalies. Elle convertit les journaux en indicateurs, comme le nombre d’exceptions fatales dans une application. Les événements du pipeline, notamment les intégrations de code, les retours en arrière, les installations, les désinstallations et les résultats des tests automatisés en production et en préproduction, devraient être enregistrés dans la même infrastructure.
Votre équipe DevOps, vous-même et les autres parties prenantes qui travaillent avec elle devriez pouvoir consulter la plateforme de télémétrie via des API et des interfaces graphiques en libre-service sans ouvrir de ticket d’accès.
Toutes vos données de télémétrie doivent être accessibles à 100 % à l’ensemble de votre organisation, à l’exception des indicateurs susceptibles de porter atteinte à la vie privée ou à la sécurité de vos clients.
Types d’indicateurs de télémétrie
- Indicateurs métier : Par exemple, les résultats des tests A/B, le bénéfice, le chiffre d’affaires, le nombre de nouveaux utilisateurs, la durée moyenne des sessions, le nombre de commandes terminées et le nombre de processus de paiement abandonnés.
- Indicateurs applicatifs : Par exemple, les temps de réponse des applications, la durée des transactions, le nombre de vidages mémoire et le nombre d’exceptions fatales.
- Indicateurs d’infrastructure : Par exemple, le trafic des serveurs, les entrées-sorties disque et réseau, la mémoire vive, le processeur et l’utilisation des disques.
- Indicateurs côté client : Par exemple, les temps de réponse et les erreurs des applications clientes Web, mobiles, JavaScript et autres.
- Indicateurs du pipeline de déploiement : Par exemple, les intégrations de code, les délais et fréquences de déploiement, l’état des environnements et les résultats verts, orange ou rouges après l’exécution des tests automatisés.
Organisez vos indicateurs en catégories et sous-catégories hiérarchiques pour que votre équipe DevOps et vous-même puissiez les interpréter facilement.
Rendez les entrées de journal des applications faciles à comprendre, car elles seront ensuite converties en indicateurs de télémétrie. Comme pour les journaux, regroupez vos indicateurs de télémétrie en catégories. Par exemple, utilisez les niveaux Debug, Info, Warn, Error et Fatal.
Appuyez-vous sur la télémétrie pour résoudre les problèmes
Dans une organisation où l’on cherche des coupables, personne ne veut rendre visibles tous les changements en production ni afficher la télémétrie. Dans ce climat, les causes profondes sont rarement bien identifiées et, pire, l’organisation ne tire aucun nouvel enseignement.
Pour que la télémétrie guide la résolution des problèmes, faites de sa création une activité quotidienne de toute l’équipe DevOps. Créez des bibliothèques simples à utiliser, afin qu’une seule ligne de code puisse produire un enregistrement de télémétrie.
Enregistrez également les écritures dans votre système de gestion des versions et vos environnements en service. La supervision rendra ainsi la relation entre les changements apportés aux systèmes et leurs effets sur vos clients facile à visualiser.
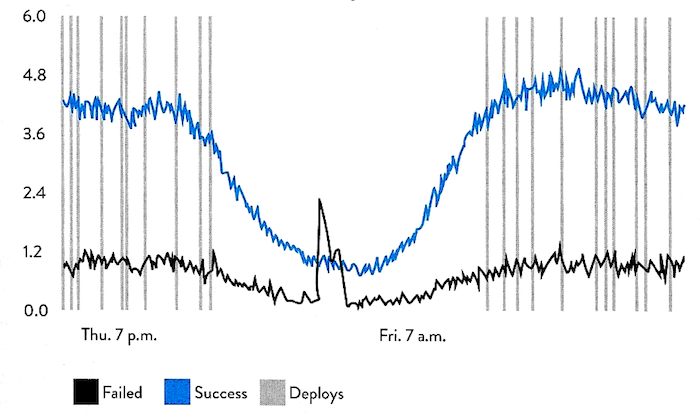
Le graphique ci-dessous montre clairement, par exemple, que l’un des derniers déploiements du jeudi soir est une cause probable de l’augmentation des échecs d’achat dans le parcours de paiement.
Comparez les déploiements réussis et échoués avec l’activité métier au fil du temps.
 Voir le schéma original ↗
(Source : Measure Anything, Measure Everything, DevOps Handbook)
La télémétrie vous permet de parler des problèmes en détail. Votre équipe DevOps et vous-même n’avez rien à cacher, ni entre vous ni à vos parties prenantes. Surveillez et présentez en temps réel des graphiques comme celui ci-dessus pour repérer rapidement les problèmes et faire apparaître d’éventuels liens de cause à effet entre les déploiements et les événements métier importants. Les équipes métier comprennent mieux votre travail et bénéficient d’une plus grande transparence. Les développeurs et ingénieurs d’exploitation DevOps voient aussi la relation entre les incidents et les déploiements.
La télémétrie permet de voir les problèmes tant qu’ils sont simples et peu coûteux à corriger. Vous pouvez les résoudre avant qu’ils se propagent ou que d’autres problèmes s’y ajoutent.
La télémétrie permet à votre équipe DevOps et à vous-même de repérer des tendances dans les principaux indicateurs métier et techniques, puis de créer des alertes en cas d’anomalie. Vos seuils d’alerte initiaux peuvent être mal réglés et produire de faux positifs. C’est tout à fait normal. Gardez votre calme et ne laissez personne minimiser les efforts et les investissements consacrés à votre infrastructure de télémétrie. Comme pour le reste de vos systèmes complexes, vous affinerez vos seuils d’alerte pour qu’ils conviennent à votre équipe, à vos clients et à votre activité.
CONCLUSION
Les organisations DevOps les plus performantes mesurent les conséquences des problèmes au moyen d’indicateurs métier, comme le nombre de clients perdus ou le manque à gagner. Toute leur organisation devient ainsi plus attentive à la télémétrie, en production comme en préproduction. Elles consacrent du temps et des ressources à la mettre en place et à l’utiliser, et s’y fient pour détecter et corriger rapidement leurs erreurs.
