
DevOpsのテキスト研修
DevOpsのソフトウェアライフサイクル管理に向けて、監視(テレメトリ)をどう構築するか
IT業界で働いていると、問題が起きたときに根本原因を突き止めるのは簡単ではないとわかります。原因はソフトウェア、実行環境、あるいはアプリケーションや環境が連携する別のコンポーネントにあるかもしれません。
比較的複雑なクライアントとサーバーの基盤が発展したこの50年で、繰り返されてきたことがあります。サーバーの動作が悪化し、エラーを出してサービスを提供できなくなると、直ることを期待してとりあえず再起動します。確かに、理解できていない問題が再起動で一時的に解消することはあります。それでも直らないと、次は、きちんと作らなかった開発者や、テストで問題を発見できなかったテスト担当者に話が向きます。こうした混乱は、サービスに対する顧客満足度に影響し、組織の職場環境も悪化させます。
高い成果を上げるDevOps組織は、問題の修正中にサーバーを再起動することはほとんどありません。体系的な方法で問題を特定し、解決します。やみくもに再起動する代わりに、本番環境のテレメトリを使い、根本原因と問題を引き起こした要因を理解します。他の組織と比べてMTTR(平均復旧時間)は96分の1です。つまり、平均的な企業より96倍速く本番の問題を解決します。高い成果を上げるDevOps組織が重視する技術的な実践は、ソフトウェアやアプリケーションにテレメトリを組み込むことです。
テレメトリとは
簡単に言えば、テレメトリはシステムの挙動を記録するプロセスです。
これを実現するために、ソフトウェア、本番環境、本番前環境、デプロイメントパイプラインが、テレメトリ用の記録を継続的に生成するよう設計します。目標は、本番環境でサービスが正しく機能しているか確かめられるだけのテレメトリを用意することです。問題が発生したら、記録を見て何が起きているかをすぐに理解し、情報に基づいて対応を決められます。
また、本番システムで何が起きていると考えているかを、実際に起きていることと照らし合わせられるため、認識が実態と一致しているか簡単に確認できます。
テレメトリ基盤を構築する
テレメトリには、二つの主要な構成要素が必要です。
- テレメトリのメトリクスを記録する仕組み 高い成果を上げるDevOps組織は、アプリケーション、環境、デプロイメントパイプラインの各層で、数十万のメトリクスを継続的に記録しています。たとえば、販売件数などのビジネスロジックのイベントや、OS、データベース、ディスクI/O、ネットワークI/O、RAM、CPU、セキュリティの監視といった、サーバー基盤の稼働状態の確認です。
- テレメトリのメトリクスを管理する中央プラットフォーム このプラットフォームは、メトリクスとイベントを保存します。可視化、傾向分析、サンプリング、アラート、異常検知が可能です。ログを、ソフトウェアの致命的な例外の件数などのメトリクスに変換します。さらに、コミット、ロールバック、インストール、アンインストール、本番と本番前の環境での自動テスト結果といったパイプライン上のイベントも、同じテレメトリ基盤に保存します。
あなたとDevOpsチーム、チームと協力するすべてのステークホルダーが、チケットを起票してアクセスを依頼せず、セルフサービスのAPIとGUIでテレメトリ基盤から情報を取得できるようにします。
顧客のプライバシーを侵害したり、安全性を損なったりする可能性のあるメトリクスを除き、すべてのテレメトリ情報は、組織全体から100%アクセスできるようにします。
テレメトリのメトリクスの種類
- ビジネス層のメトリクス A/Bテストの結果、利益、売上高、新規ユーザー数、平均セッション時間、完了した注文数、途中で中断された購入手続きの件数など。
- アプリケーション層のメトリクス アプリケーションの応答時間、取引の所要時間、コアダンプの数、致命的な例外の件数など。
- インフラ層のメトリクス サーバートラフィック、ディスクI/O、ネットワークI/O、RAM、CPU、ディスクの使用量など。
- クライアント層のメトリクス ウェブ、モバイル、JavaScript、その他のクライアントアプリケーションの応答時間とエラーなど。
- デプロイメントパイプライン層のメトリクス チェックイン、デプロイのリードタイムと頻度、環境の状態、自動テスト実行後の緑・黄・赤のステータスなど。
あなたとDevOpsチームがメトリクスを解釈しやすくなるよう、複数のカテゴリとその下のサブカテゴリに分け、階層化することが非常に重要です。
後でテレメトリのメトリクスに変換するアプリケーションのログは、理解しやすくします。ログをさまざまなイベントカテゴリに分けるように、テレメトリのメトリクスも分類します。たとえば、Debug、Info、Warn、Error、Fatalなどのレベルに分けます。
テレメトリの情報を問題解決の手掛かりにする
責任を問う文化のある組織では、本番システムでの変更を完全に可視化したい人も、テレメトリを公開したい人もいません。こうした環境では問題の根本原因を正しく特定できることは少なく、何より組織として新たに学ぶことがありません。
テレメトリを問題解決に役立てるには、テレメトリを作ることをDevOpsチーム全員の日常業務にします。使いやすいライブラリを作り、わずか1行のコードでテレメトリを簡単に記録できるようにします。
さらに、バージョン管理システムと稼働中の環境への書き込みイベントもテレメトリに記録します。監視データから、システムへの変更と、それが顧客に与えた影響の相関関係を簡単かつ明確に可視化できます。
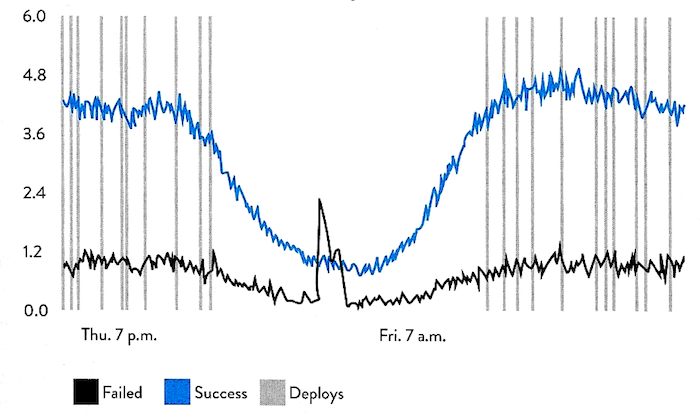
たとえば下のグラフから、木曜の夕方に行った最後のほうのデプロイの一つが、購入手続きの失敗を増加させた根本原因である可能性が高いとわかります。
時間の経過に沿って、デプロイの成功・失敗と事業活動を比較します。
 出典の図を見る ↗
(出典:Measure Anything, Measure Everything、DevOps Handbook)
テレメトリがあれば、問題について詳しく伝えられます。あなたとDevOpsチームは、チーム内でもステークホルダーに対しても、隠すことはありません。上のようなグラフを常に監視してステークホルダーにリアルタイムで提示すれば、問題をすばやく特定し、デプロイと主なビジネスイベントとの間にあり得る因果関係を把握できます。事業部門にはチームの仕事がより明確に見え、理解が深まります。DevOps開発者とDevOps運用エンジニアも、インシデントとデプロイの関係を把握できます。
テレメトリによって、簡単かつ低コストで直せるうちに問題を発見できます。問題が広がり、その上に別の問題が積み重なる前に解消できます。
テレメトリを使うと、事業や技術の主要指標のパターンを把握し、異常が起きたときにアラートを出せます。最初はしきい値が適切でなく、誤検知が出ることもあります。ごく普通のことなので、慌てる必要はありません。テレメトリ基盤を作るための努力と投資を、軽んじる人に妨げられないようにしてください。複雑なシステムの他の要素と同じように、問題を理解し、しきい値を調整して、チーム、顧客、事業の役に立つアラートにできます。
まとめ
DevOpsで高い成果を上げる組織は、失った顧客数や売上など、測定できる事業指標で問題の影響を把握します。組織の全員が、本番環境だけでなく本番前環境のテレメトリにも、より注意を払うようになります。テレメトリの構築と利用に時間とリソースを投じ、エラーをすばやく見つけて解消するために活用します。
