
लिखित DevOps प्रशिक्षण
सॉफ़्टवेयर जीवनचक्र के लिए निगरानी और टेलीमेट्री कैसे बनाएँ?
IT के अनुभव से पता है कि कुछ ग़लत हो, तो उसका मूल कारण ढूँढना आसान नहीं। समस्या ऐप्लिकेशन, परिवेश या उनसे जुड़े कंपोनेंट में हो सकती है।
पिछले 50 वर्षों में जटिल क्लाइंट और सर्वर प्लैटफ़ॉर्म में यह अक्सर हुआ है: सर्वर ठीक काम न करे और त्रुटि दे, तो उसे दोबारा शुरू करके उम्मीद करते हैं कि समस्या हल होगी। कभी रीस्टार्ट से बिना समझी समस्या थोड़ी देर के लिए चली जाती है। इससे मदद न मिले, तो उन डेवलपर और टेस्टर के पास जाते हैं जिन्होंने शायद ठीक डिलीवरी नहीं की या टेस्ट में त्रुटि नहीं पकड़ी। इस अफ़रा-तफ़री से ग्राहक संतुष्टि और काम का माहौल, दोनों प्रभावित होते हैं।
अग्रणी DevOps संगठन समस्या सुधारते समय सर्वर मुश्किल से रीस्टार्ट करते हैं। वे व्यवस्थित तरीके से समस्या पहचानते और हल करते हैं। बिना सोचे रीस्टार्ट करने के बजाय प्रोडक्शन टेलीमेट्री से मूल कारण और दूसरे कारक समझते हैं। उनका बहाली का औसत समय (MTTR) 96 गुना बेहतर है। यानी वे सामान्य कंपनी से 96 गुना तेज़ प्रोडक्शन समस्याएँ हल करते हैं। उनकी मुख्य तकनीकी प्रथा सॉफ़्टवेयर और ऐप्लिकेशन में टेलीमेट्री जोड़ना है।
टेलीमेट्री क्या है?
सरल शब्दों में टेलीमेट्री आपके सिस्टम के व्यवहार को रिकॉर्ड करती है।
सॉफ़्टवेयर, प्रोडक्शन और प्री-प्रोडक्शन परिवेश और पाइपलाइन ऐसे डिज़ाइन करें कि वे लगातार टेलीमेट्री रिकॉर्ड बनाएँ। इतनी जानकारी जुटाएँ कि प्रोडक्शन सेवाओं के सही काम की पुष्टि हो सके। समस्या होने पर रिकॉर्ड देखकर जल्दी समझ सकते हैं कि क्या हुआ और उसे सुधारने का जानकारी-आधारित फ़ैसला कर सकते हैं।
टेलीमेट्री से आप अपनी समझ और प्रोडक्शन में असल में जो हो रहा है, उसका मिलान कर सकते हैं।
अपना टेलीमेट्री इन्फ़्रास्ट्रक्चर बनाएँ
टेलीमेट्री के दो प्रमुख हिस्से चाहिए:
- टेलीमेट्री मेट्रिक्स रिकॉर्ड करना: सभी उच्च प्रदर्शन वाले DevOps संगठन ऐप्लिकेशन, परिवेश और पाइपलाइन के हर स्तर पर लगातार कई लाख मेट्रिक्स रिकॉर्ड करते हैं। जैसे बिक्री की संख्या या सर्वर प्लैटफ़ॉर्म की स्थिति जाँचने के लिए ऑपरेटिंग सिस्टम, डेटाबेस, डिस्क और नेटवर्क I/O, RAM, CPU और सुरक्षा की निगरानी।
- टेलीमेट्री मेट्रिक्स के प्रबंधन का केंद्रीय प्लैटफ़ॉर्म: यह मेट्रिक्स और घटनाएँ रखता है और विज़ुअलाइज़ेशन, रुझान, सैंपलिंग, चेतावनी और असामान्य गतिविधि पहचानने में मदद करता है। यह लॉग को मेट्रिक्स में बदलता है, जैसे किसी ऐप्लिकेशन में गंभीर अपवादों की संख्या। पाइपलाइन की घटनाएँ, जैसे कमिट, रोलबैक, इंस्टॉलेशन, अनइंस्टॉलेशन और प्रोडक्शन व प्री-प्रोडक्शन के ऑटोमेटेड टेस्ट परिणाम, भी उसी इन्फ़्रास्ट्रक्चर में रखें।
आप, टीम और साथ काम करने वाले हितधारक टिकट खोले बिना सेल्फ़-सर्विस API और GUI से टेलीमेट्री की जानकारी निकाल सकें।
पूरे संगठन को टेलीमेट्री की 100% जानकारी उपलब्ध होनी चाहिए, उन मेट्रिक्स को छोड़कर जिनसे गोपनीयता का उल्लंघन या ग्राहकों की सुरक्षा का खतरा हो।
टेलीमेट्री मेट्रिक्स के प्रकार
- बिज़नेस स्तर के मेट्रिक्स: A/B टेस्ट परिणाम, लाभ, आय, नए उपयोगकर्ताओं की संख्या, सत्र की औसत अवधि, पूरे ऑर्डर और बीच में छोड़े गए चेकआउट।
- ऐप्लिकेशन स्तर के मेट्रिक्स: ऐप्लिकेशन का प्रतिक्रिया समय, लेनदेन की अवधि, कोर डंप और गंभीर अपवादों की संख्या।
- इन्फ़्रास्ट्रक्चर स्तर के मेट्रिक्स: सर्वर ट्रैफ़िक, डिस्क और नेटवर्क I/O, RAM, CPU और डिस्क का इस्तेमाल।
- क्लाइंट स्तर के मेट्रिक्स: वेब, मोबाइल, JavaScript और अन्य क्लाइंट ऐप्लिकेशन का प्रतिक्रिया समय और त्रुटियाँ।
- डिप्लॉयमेंट पाइपलाइन स्तर के मेट्रिक्स: चेक-इन, डिप्लॉयमेंट का लीड टाइम और आवृत्ति, परिवेशों की स्थिति और ऑटोमेटेड टेस्ट के हरे, पीले और लाल परिणाम।
मेट्रिक्स को श्रेणियों और उपश्रेणियों में रखें, ताकि आप और टीम आसानी से उनका मतलब समझें।
ऐप्लिकेशन की लॉग प्रविष्टियाँ समझने में आसान बनाएँ, क्योंकि वे बाद में मेट्रिक्स बनेंगी। जैसे लॉग घटनाओं की श्रेणियों में होते हैं, वैसे मेट्रिक्स भी समूहों में रखें, जैसे Debug, Info, Warn, Error और Fatal।
समस्या सुलझाने के लिए टेलीमेट्री इस्तेमाल करें
दोषारोपण की संस्कृति में कोई प्रोडक्शन के बदलाव पूरी तरह नहीं दिखाना चाहता और कोई टेलीमेट्री नहीं दिखाता। ऐसे माहौल में मूल कारण कम ही सही पहचाने जाते हैं और सबसे बुरी बात यह है कि संगठन कुछ नया नहीं सीखता।
समस्या सुलझाने में टेलीमेट्री की मदद लेने के लिए उसे बनाना पूरी टीम का रोज़ का काम हो। आसान लाइब्रेरी बनाएँ, ताकि कोड की एक पंक्ति से टेलीमेट्री रिकॉर्ड बने।
वर्शन कंट्रोल और चलते परिवेशों में लिखने की घटनाओं के भी रिकॉर्ड बनाएँ। इससे निगरानी में साफ़ दिखेगा कि सिस्टम के बदलाव और ग्राहकों पर उनका असर कैसे जुड़े हैं।
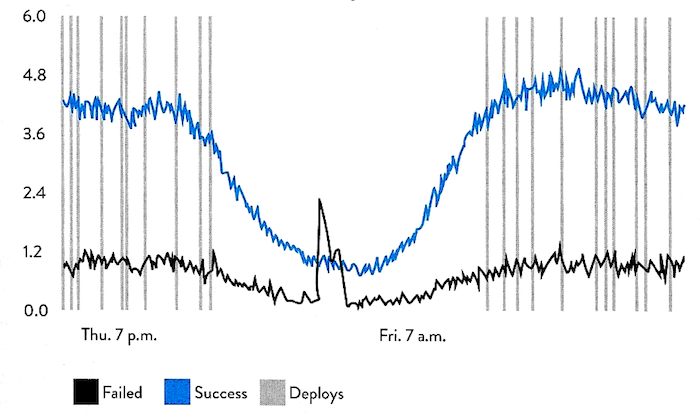
उदाहरण के लिए नीचे के चार्ट में दिखता है कि गुरुवार शाम के आखिरी डिप्लॉयमेंट में से एक शायद चेकआउट में बढ़ी विफल खरीद का कारण था।
समय के साथ सफल और विफल डिप्लॉयमेंट की तुलना व्यावसायिक गतिविधि से करें।
 मूल डायग्राम देखें ↗
(स्रोत: Measure Anything, Measure Everything, DevOps Handbook)
टेलीमेट्री से समस्याओं पर विस्तार से बात कर सकते हैं। टीम को एक-दूसरे और हितधारकों से कुछ छिपाना नहीं है। ऐसे चार्ट लगातार देखें और वास्तविक समय में हितधारकों को दिखाएँ, ताकि समस्या और डिप्लॉयमेंट व मुख्य व्यावसायिक घटनाओं के बीच संभावित कारण जल्दी दिखें। व्यावसायिक टीमों को आपके काम की बेहतर समझ और पारदर्शिता मिलती है। डेवलपर और ऑपरेशंस इंजीनियर घटनाओं और डिप्लॉयमेंट का संबंध देखते हैं।
टेलीमेट्री से समस्याएँ तब दिखती हैं जब उन्हें ठीक करना आसान और सस्ता है। फैलने और उन पर दूसरी समस्याएँ बनने से पहले सुधारें।
टेलीमेट्री से अहम व्यावसायिक और तकनीकी मेट्रिक्स के पैटर्न पहचानकर असामान्य बदलाव पर अलर्ट बना सकते हैं। शुरू में अलर्ट की सीमाएँ ग़लत हो सकती हैं और ग़लत चेतावनियाँ दे सकती हैं। यह सामान्य है। घबराएँ नहीं और अपने इन्फ़्रास्ट्रक्चर के लिए मेहनत और निवेश कम न होने दें। जटिल सिस्टम के बाकी हिस्सों की तरह यहाँ भी समय के साथ सही सीमा खोजकर उसे अपने, ग्राहकों और व्यवसाय के लिए ठीक करेंगे।
निष्कर्ष
अग्रणी DevOps संगठन समस्याओं के असर को मापने योग्य व्यावसायिक मेट्रिक्स में दिखाते हैं, जैसे खोए हुए ग्राहकों की संख्या या आय। इससे पूरे संगठन में टेलीमेट्री की अहमियत समझ आती है, प्रोडक्शन और प्री-प्रोडक्शन दोनों में। वे टेलीमेट्री बनाने और इस्तेमाल करने में समय और संसाधन लगाते हैं और त्रुटियाँ जल्दी पहचानने और सुधारने के लिए उस पर भरोसा करते हैं।
