
Formazione scritta DevOps
Come creare un sistema di monitoraggio (telemetria) per gestire il ciclo di vita del software DevOps?
Dall'esperienza nel settore IT sai che quando qualcosa va storto è difficile individuare le cause alla radice. Il problema può trovarsi nelle applicazioni, negli ambienti o in altri componenti con cui sono integrati.
Osservando lo sviluppo delle piattaforme client e server relativamente complesse negli ultimi 50 anni, si nota una situazione ricorrente. Quando un server comincia a funzionare male, generare errori e non dare i risultati attesi, lo riavvii sperando di risolvere. A volte il riavvio rimuove temporaneamente un problema che non hai mai compreso. Se non basta, ti rivolgi a sviluppatori e tester accusandoli di non aver consegnato bene o di non aver trovato i problemi durante i test. Il caos riduce la soddisfazione dei clienti e danneggia il clima di lavoro.
Le migliori organizzazioni DevOps riavviano raramente i server quando risolvono i problemi. Seguono approcci sistematici per individuarli e correggerli. Si affidano alla telemetria di produzione per comprenderne le cause e i fattori che vi contribuiscono, evitando di riavviare i server alla cieca. Il loro MTTR (tempo medio di ripristino) è 96 volte più breve di quello delle altre organizzazioni. In altre parole, risolvono i problemi in produzione 96 volte più rapidamente di un'azienda media. Una delle loro pratiche tecniche principali è integrare la telemetria nel software e nelle applicazioni.
Cos'è la telemetria?
In parole semplici, la telemetria è il processo di registrazione del comportamento dei sistemi.
Per ottenerla, progetta il software, gli ambienti di produzione e preproduzione e la pipeline di deployment affinché generino continuamente dati di telemetria. L'obiettivo è raccoglierne abbastanza per verificare che i servizi funzionino correttamente in produzione. Quando emerge un problema, esaminando i dati puoi capirlo rapidamente e prendere decisioni informate per correggerlo.
La telemetria ti aiuta inoltre a confrontare ciò che pensi accada nei sistemi di produzione con ciò che vi accade realmente, così puoi verificare facilmente se le due cose corrispondono.
Crea l'infrastruttura di telemetria
Per disporre della telemetria servono due componenti principali:
- Registrazione delle metriche di telemetria: Tutte le organizzazioni DevOps più performanti registrano continuamente centinaia di migliaia di metriche a ogni livello delle applicazioni, degli ambienti e della pipeline di deployment. Tra gli esempi ci sono eventi della logica di business, come il numero di vendite, o controlli sullo stato dei server, come il monitoraggio di sistemi operativi, database, I/O su disco e rete, RAM, CPU e sicurezza.
- Piattaforma centralizzata per gestire le metriche di telemetria: La piattaforma archivia metriche ed eventi. Consente visualizzazione, analisi delle tendenze, campionamento, avvisi e rilevamento delle anomalie. Converte i log in metriche, come il numero di eccezioni fatali in un'applicazione. Nella stessa infrastruttura vanno conservati anche gli eventi della pipeline, come commit, rollback, installazioni, disinstallazioni e risultati dei test automatizzati in produzione e preproduzione.
Tu, il team DevOps e tutte le altre persone che vi collaborano dovreste poter recuperare le informazioni dalla piattaforma di telemetria tramite API e interfacce grafiche self-service, senza aprire ticket per richiedere l'accesso.
Il 100% delle informazioni di telemetria deve essere accessibile a tutta l'organizzazione, salvo le metriche che potrebbero violare la riservatezza o compromettere la sicurezza dei clienti.
Tipi di metriche di telemetria
- Metriche di business: Per esempio, risultati dei test A/B, utile, ricavi, numero di nuovi utenti, durata media delle sessioni, numero di ordini completati e numero di procedure di acquisto abbandonate.
- Metriche applicative: Per esempio, tempi di risposta delle applicazioni, durata delle transazioni, numero di core dump ed eccezioni fatali.
- Metriche infrastrutturali: Per esempio, traffico dei server, operazioni di I/O su disco e di rete e utilizzo di RAM, CPU e disco.
- Metriche lato client: Per esempio, tempi di risposta delle applicazioni client ed errori nelle applicazioni web, mobili, JavaScript e altre applicazioni client.
- Metriche della pipeline di deployment: Per esempio, check-in, lead time di deployment, frequenze, stato degli ambienti ed esiti verdi, gialli o rossi dei test automatizzati.
Organizzare le metriche in gerarchie con categorie e sottocategorie annidate è fondamentale perché tu e il team DevOps possiate interpretarle facilmente.
Rendi comprensibili le voci dei log applicativi che verranno convertite in metriche. Come raggruppi i log per categorie di eventi, raggruppa anche le metriche di telemetria. Un esempio sono i livelli Debug, Info, Warn, Error e Fatal.
Usa i dati di telemetria per orientare la risoluzione dei problemi
Se nell'organizzazione vige una cultura della colpa, nessuno vuole rendere pienamente visibili le modifiche in produzione o mostrare la telemetria. In questo clima è raro individuare correttamente le cause dei problemi e, soprattutto, l'organizzazione non acquisisce nuove conoscenze.
Per usare la telemetria nella risoluzione dei problemi, assicurati che crearla diventi parte del lavoro quotidiano di tutto il team DevOps. Crea librerie facili da usare, in modo che basti una riga di codice per registrare un dato di telemetria.
Registra inoltre gli eventi di scrittura del sistema di controllo di versione e degli ambienti in funzione. Il monitoraggio della telemetria renderà così facile visualizzare la correlazione tra le modifiche ai sistemi e il loro effetto sui clienti.
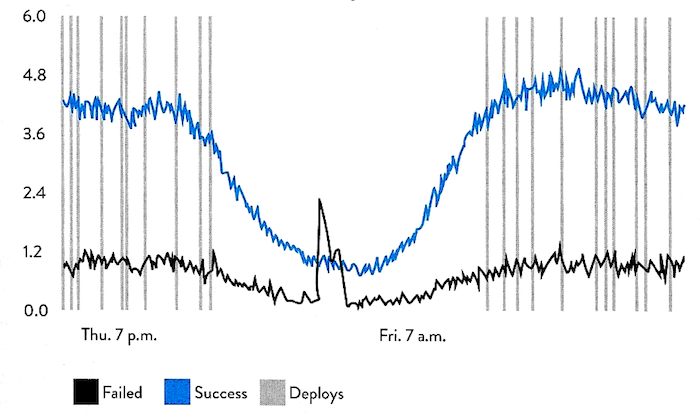
Per esempio, dal grafico seguente si vede chiaramente che uno degli ultimi deployment di giovedì sera è una probabile causa dell'aumento degli acquisti non riusciti nella procedura di pagamento.
Confronta i deployment riusciti e falliti con l'andamento delle attività aziendali.
 Vedi il diagramma originale ↗
(fonte: Measure Anything, Measure Everything, DevOps Handbook)
La telemetria ti aiuterà a comunicare i problemi in dettaglio. Tu e i team DevOps non avete nulla da nascondere tra voi o ai portatori di interesse. Monitorate e presentate loro in tempo reale grafici come quello qui sopra, per individuare rapidamente i problemi e vedere eventuali rapporti di causa ed effetto tra deployment ed eventi aziendali chiave. Le persone che si occupano di business comprendono meglio il lavoro del team e hanno maggiore visibilità. I DevOps Developer e i DevOps Operations Engineer vedono inoltre la correlazione tra incidenti e deployment.
La telemetria ti permette di vedere i problemi quando è ancora facile ed economico risolverli, così puoi correggerli prima che si propaghino e ne generino altri.
Con la telemetria, tu e il team DevOps potete individuare schemi nelle metriche chiave di business e tecnologiche e creare avvisi per le anomalie. All'inizio le soglie possono essere sbagliate e generare falsi positivi. È normale. Non farti prendere dal panico e non lasciare che qualcuno sminuisca l'impegno e l'investimento nell'infrastruttura di telemetria. Come per il resto dei sistemi complessi, capirai come regolare le soglie degli avvisi perché funzionino per te, per i clienti e per l'azienda.
CONCLUSIONE
Le migliori organizzazioni DevOps misurano l'impatto dei problemi con metriche aziendali quantificabili, come il numero di clienti persi o il mancato fatturato. Tutti diventano così più consapevoli della telemetria, sia in produzione sia in preproduzione. Investono tempo e risorse per crearla e usarla e vi si affidano per individuare e correggere rapidamente gli errori.
